
理解检索增强生成的六步流程与三个 GEO 切入点
一、RAG 是什么:生成式搜索的核心架构
传统搜索引擎的核心是倒排索引——关键词匹配、网页排序、用户点击;生成式 AI 搜索的核心则是 RAG(Retrieval-Augmented Generation,检索增强生成)——用户提问、查询分解、并行检索、片段提取、生成回答。SEO 优化的是排序算法,GEO 优化的则是整条 RAG 管线:让品牌的内容在每一个环节都被优先选中。
二、六步管线拆解
RAG 的工作流程可拆解为六个环节:用户提问;查询解析与意图理解(识别实体、约束条件与核心意图);查询重构(将复杂问题拆解为多个可检索的子查询);并行信息检索(在实时网络索引中召回候选内容);信息提取与综合(从检索结果中提取关键数据点);增强提示构建与答案生成引用(整合事实并生成带引用的回答)。
三、三个 GEO 切入点
对品牌而言,这条管线中存在三个关键入口。切入点一在检索环节:品牌内容必须能被检索到——这本质上是传统 SEO 的工作,要求网站技术健康、可被抓取、具备基础权威性。切入点二在提取环节:内容必须容易被提取——这是 GEO 的核心战场,内容的结构化程度决定了 AI 能否准确抽取关键信息。切入点三在生成环节:品牌必须被正面引用——措辞、实体关联与权威信号共同决定 AI 是否把品牌写入答案。
四、信息论视角:什么样的内容更容易被引用
从信息论角度看,GEO 友好内容的核心是最大化结构信息增益,具体有六个可操作方向:一是用具体数据替代空话,高信息熵的句子在片段提取中优先级远高于套话;二是引入权威命名实体,机构名、标准名、认证名在知识图谱中具有天然高权重;三是保持清晰的标题层级,让 AI 能精准定位到与问题相关的段落;四是善用列表、表格与要点,进一步细化内容结构;五是提供原创见解与独特分析,使内容与通用语料形成显著差异;六是避免模糊表述,确保段落级核心信息明确无歧义。行业实践中还强调“语义熵”的控制——确保每千字信息熵不低于约 3.2 比特,在有限篇幅内承载尽可能多的有效信息。
五、Schema 结构化数据:给 AI 看的“官方语言”
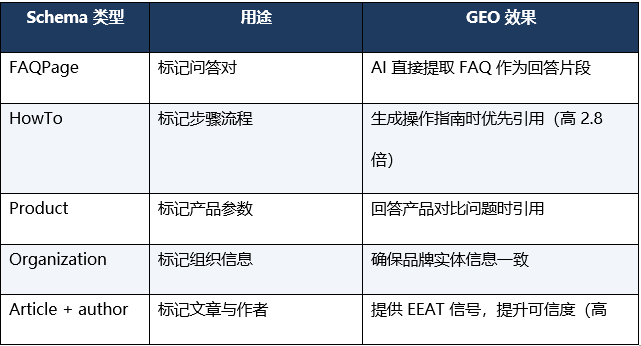
部署 Schema 是 GEO 中投入产出比最高的动作之一。它是连接“人类长文”与“机器理解”的桥梁,相当于给页面附上一份“机器说明书”:明确内容类型、标出关键信息、提前拆成可单独调用的知识块。
六、llms.txt 与 robots.txt:面向大模型的“站点地图”
2025-2026 年兴起的新实践,是在网站根目录部署 llms.txt 文件。它之于大模型,类似于 robots.txt 之于搜索引擎爬虫:声明哪些内容是官方认可的最新版本、提供网站内容的语义摘要,并减少 AI 抓取到过时或错误信息的风险。同时要正确配置 robots.txt,区分引用爬虫(OAI-SearchBot、ClaudeBot、PerplexityBot,决定实时引用,应放行)与训练爬虫(GPTBot、Google-Extended,决定是否进入训练语料,可视企业策略决定)。
技术可读、内容可解释、信源可信,是 GEO 的三类核心资产
参考资料
- 阿里云开发者社区:GEO 底层逻辑:大模型时代的数据分发管线重构,2026 年 5 月
- 腾讯云开发者社区:语义时代的知识分发:深度解析 RAG 架构下的 GEO 与 AI 搜索优化逻辑,2025 年 12 月
- Similarweb:Generative Engine Optimization: The Complete 2026 Guide,2026 年 3 月